
Por Sophie Ale
Um botão pode ter a fonte correta, o contraste aprovado e o espaçamento previsto no Figma — e ainda falhar quando recebe um nome com acento combinante, um símbolo decorativo ou um caractere invisível. O problema não está necessariamente no desenho do componente. Pode estar no caminho que o texto percorre entre teclado, aplicativo, navegador, validação e banco de dados.
Ao discutir sistemas visuais para marcas premium, a IV Criativa destaca que tokens, componentes, conteúdo e regras de uso precisam evoluir juntos. O passo seguinte é incluir nesse acordo os casos reais de texto que as pessoas digitam, copiam e colam.
O limite dos tokens tipográficos
Um token como text-body-md define tamanho, peso e altura de linha. Já a sequência de caracteres de um nome chega de outra camada: o conteúdo. Uma família tipográfica pode renderizar perfeitamente “Marina” e não ter um glifo adequado para determinado símbolo; um campo pode exibir o texto corretamente e, ainda assim, compará-lo de maneira inconsistente.
Por isso, vale documentar duas responsabilidades diferentes: tipografia do componente (hierarquia, estados, fontes de fallback e truncamento) e política de entrada de texto (caracteres aceitos, normalização, validação, cópia e mensagens de erro). A primeira está no sistema visual; a segunda depende do produto e deve ser acordada com engenharia e conteúdo.
1. O mesmo “é” pode chegar por dois caminhos
Considere “Café”. A letra “é” pode ser representada por U+00E9 ou pela sequência “e” (U+0065) seguida de acento agudo combinante (U+0301). As duas formas são canonicamente equivalentes, mas os bytes não são idênticos antes da normalização. Essa distinção pode afetar buscas, deduplicação e testes automatizados que fazem comparação literal.
Para texto geral, uma prática útil é testar normalização NFC antes de comparar valores equivalentes. Isso não significa remover todos os acentos nem aplicar transformações indiscriminadas: nomes próprios, senhas, identificadores e requisitos linguísticos precisam de políticas próprias. O Unicode Consortium documenta as formas NFC, NFD, NFKC e NFKD e ressalta que as formas de compatibilidade podem perder distinções relevantes.
2. Letra estilizada não é uma configuração de fonte
Uma interface pode definir uma fonte CSS para o texto comum, enquanto o usuário cola caracteres que já possuem aparências especiais no Unicode. O resultado depende da cobertura de glifos, das fontes disponíveis e do tratamento realizado pelo aplicativo. Se o caractere não estiver disponível, podem surgir quadradinhos ou substituições inesperadas.
Uma forma transparente de demonstrar a diferença é usar um gerador de letras diferentes como bancada de experimentação: copiar uma versão decorativa de “Luna”, colá-la em um campo de perfil, compará-la com o nome normal e verificar se continua legível, pesquisável e distinguível. O objetivo do teste é observar limitações, não sugerir que esse estilo seja adequado a todos os campos.
Regra prática: estilos criativos podem ser apropriados para uma bio informal ou uma peça visual. Para identificadores, botões críticos e dados de contato, priorize caracteres previsíveis e nomes reconhecíveis.
3. O que um caractere invisível revela sobre o formulário
Texto aparentemente vazio nem sempre é uma string vazia. O caractere U+200B (ZERO WIDTH SPACE), por exemplo, não ocupa largura visível, mas continua presente no conteúdo. Outros pontos de código usados como “espaço invisível” têm propriedades diferentes; U+3164 é HANGUL FILLER, não um espaço comum. Aplicativos podem aceitar, ignorar, sinalizar ou rejeitar esses caracteres conforme suas próprias regras.
Em uma demonstração controlada, a ferramenta de caractere invisível permite copiar diferentes caracteres e observar o que acontece ao colá-los. No Design System, porém, a pergunta correta é: “Esse campo admite essa entrada?”. Um campo de observações pode ter regras distintas de um nome de usuário; um botão de confirmar não deve aparentar sucesso quando a entrada foi silenciosamente alterada.
Testes relevantes: diferenciar campo realmente vazio de conteúdo sem largura; mostrar uma mensagem compreensível quando a regra do produto rejeita certo caractere; conferir o texto após salvar, recarregar e copiar; e não recorrer a remoções automáticas que alterem nomes legítimos sem necessidade.
4. Botões, ícones e nomes acessíveis
Um botão representado apenas por “★” pode parecer evidente para quem vê a tela, mas o símbolo isolado não comunica necessariamente a ação. O W3C recomenda nomes acessíveis coerentes com o propósito do controle e prefere texto visível quando ele pode servir como nome. Em um botão somente com ícone, é preciso disponibilizar um nome identificável pela tecnologia assistiva.
Inclua nos testes: rótulo visível versus nome acessível; navegação por teclado; leitura com tecnologia assistiva; contraste; estado de foco; zoom; e situações em que um caractere especial ocupa mais largura que o esperado. A validação não termina em um print bonito do componente.
5. A matriz mínima de testes de texto
Uma biblioteca de componentes pode ganhar um conjunto enxuto de casos de regressão que acompanha cada nova versão. O importante é registrar a expectativa, o comportamento observado e a regra do produto — não supor que todo símbolo precisa ser aceito.
| Teste | Entrada ilustrativa | Critério de verificação |
|---|---|---|
| Acento composto | “Café” e “Café” | Comparação consistente segundo a política definida |
| Nome longo | “Maria de Fátima Albuquerque” | Sem sobreposição; truncamento recuperável quando aplicável |
| Unicode decorativo | “𝓛𝓾𝓷𝓪” | Fallback previsível ou rejeição explicada |
| Invisível | “Lu” + U+200B + “na” | Validação explícita e comportamento após salvar |
| Ícone isolado | Botão “★” | Nome acessível que descreve a ação |
| Copiar e colar | Campo → confirmação → edição | Texto preservado ou transformação documentada |
Da documentação à governança
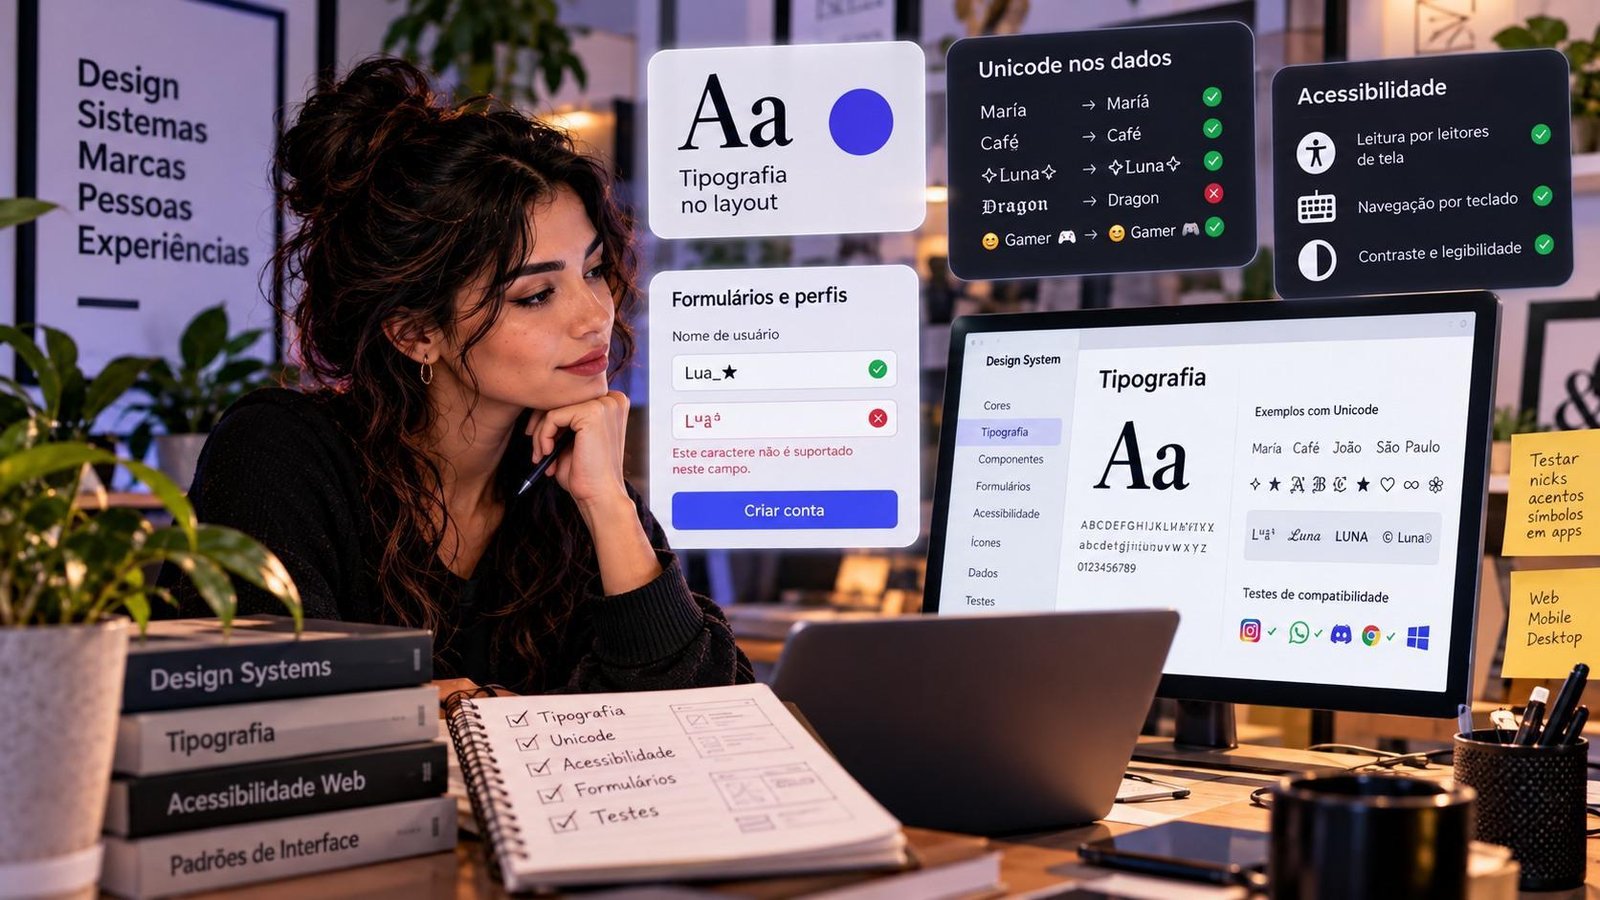
O teste de texto deve entrar no mesmo ciclo de design-to-code de cores, espaçamentos e estados. Para cada componente, documente entradas previstas, limites, tratamento de erros, fallback tipográfico e quem decide sobre exceções. Os resultados podem ser registrados com screenshots e reproduções mínimas no ambiente real, em vez de depender exclusivamente de mockups.
Uma revisão de entrega pode seguir quatro perguntas: (1) o usuário entende o que deve escrever? (2) o componente preserva a informação necessária? (3) a experiência segue compreensível sem depender de um símbolo visual? (4) o comportamento é consistente entre edição, gravação e leitura? Se uma resposta for “não”, existe uma falha de experiência — ainda que o layout siga o Figma ao pixel.
Um Design System maduro não promete que todo Unicode se comportará da mesma forma em todos os aparelhos. Ele define critérios de aceitação, torna limites compreensíveis e evita que decisões importantes fiquem escondidas entre design, front-end e dados.
Fontes editoriais para conferência
IV Criativa — Design System para Marcas Premium: A Base da Consistência e Inovação Digital
Unicode Consortium — FAQ: Normalization
W3C WAI-ARIA — Providing Accessible Names and Descriptions
Sobre a autora
Sophie Ale escreve sobre tipografia digital, caracteres Unicode e comunicação visual. No Letras Diferentes, investiga usos criativos e limites práticos da personalização de texto. Perfil de Sophie Ale.